Research · 研究
研究
我的研究主要围绕 AI for Science 展开,关注机器学习如何真正进入科学问题。目前从分子机器学习、量子化学与材料研究出发,把科学计算、数据、模型和科研工作流连接起来,并逐渐向激发态、自旋化学、CISS 与更广泛的计算科学问题延伸。
AI for Science 研究主线
分子机器学习 + 量子化学:以 D–A 有机光催化材料为当前主战场,把科学计算、数据、模型与科研工作流连接成完整链条。
方向延伸:激发态性质 → 自旋化学 → CISS → 量子态动力学。
研究中的判断
观点 01
科学问题优先
AI for Science 的核心仍然是科学问题,模型指标只是研究链条中的一部分。
观点 02
协议与数据同样重要
数据质量、计算协议和评价方式与模型结构同样重要。
观点 03
进入真实流程
我更关注模型能否真正进入计算、验证和候选筛选流程。
观点 04
长期兴趣
对量子化学、分子学习、自旋化学及跨学科科学问题保持长期兴趣。
我一直很喜欢把不同领域的问题放到一起看。化学、材料、物理、机器学习和软件工程本来有各自的语言,但很多真正有意思的问题恰好发生在这些边界上。我也很享受从完全不熟悉开始,一点点把一个领域弄明白的过程。
研究版图
D–A 有机光催化材料设计与筛选 · AI4S 科研项目
ExcitationNexus · 分子计算与候选筛选科研平台
NanoPUF · 聚合物自组装与 AI 芯片身份验证
代表性科研数据、模型结果及技术路线
长案例 · D-A 有机光催化 AI4S
从量子化学到 AI 辅助候选筛选:一个完整的研究思路,而不只是模型指标。
如何在高成本激发态量子化学计算与大规模候选筛选之间建立可验证的 AI 映射?
- D-A 有机光催化材料的光生电荷分离与激子结合能与激发态电子结构密切相关,但可靠评估往往依赖更高成本的量子化学计算。
- 单纯追求模型精度不足以解决科研问题,还需要明确数据来源、不同计算保真度之间的关系、评估协议,以及模型进入候选筛选流程的方式。
2.6 万分子级计算 / 筛选队列
0.0702 eV最佳独立测试 MAE
0.1034 eV独立测试 RMSE
0.7575独立测试 R²
多保真度分层计算管线
分子结构D–A 体系录入与规范化
→
PM6低成本电子结构proxy 层
→
DFT几何与电子性质中间层
→
TDDFT / Multiwfn激发态参考reference 层
- 建立核心 D-A 数据与外部历史数据的分层治理思路,避免将来源、精度和用途不同的数据简单混合作为同一训练集。
- 使低成本电子结构 proxy 可以与高精度激发态参考结果建立可比较的映射。
- 当前整体数据生产与候选筛选流程正扩展至约 2.6 万个分子体系,为后续高通量虚拟筛选提供计算底座。
donor / acceptor 分解 + 3D 分子学习
DONOR 支路
Donor 片段 · 3D 分子表征
供体 – 受体表征交互与融合PM6 HOMO / LUMO / frontier gap 等 cheap proxy 注入
激子结合能等激发态性质预测
ACCEPTOR 支路
Acceptor 片段 · 3D 分子表征
- 利用 D-A 分子的天然双片段结构,探索 donor / acceptor 双塔 3D 分子模型,使供体与受体表征在交互与融合中保留结构角色。
- 引入 PM6 HOMO、LUMO 与 frontier-orbital gap 等低成本电子结构信息,验证 cheap quantum proxy 对目标性质预测的补充价值。
- 当前最佳模型独立测试 MAE 0.0702 eV、RMSE 0.1034 eV、R² 0.7575。研究重点不仅是「更低 MAE」,也包括理解哪些低成本物理信息能够稳定贡献增益。
ExcitationNexus
- 将分子录入与规范化、计算任务管理、结果解析、特征构建、模型预测和候选排序连接成统一科研工作流。
- 通过结构化记录减少分子结构、计算文件、特征表与预测结果分散在不同目录和脚本中的版本混乱。
- 平台定位为科研工作流和候选初筛辅助工具,不替代高精度计算与实验验证。
对于当前任务,更有价值的方向是把低成本电子结构信息、3D 分子表征、严格评估协议与计算工作流结合起来。后续将继续扩展多目标激发态性质、不确定性 / OOD、主动筛选,以及自旋化学与 CISS 相关研究。
为什么这个案例代表我的研究方式
- 先把科学问题和计算成本拆清楚,再决定 AI 应该介入哪一层,而不是先选模型再寻找任务。
- 把负结果也当作研究信息,关注「哪类 cheap feature 有效、哪类模型路线不值得继续」,避免只保留成功实验。
- 让数据治理、计算、模型、评估与平台形成闭环,使一次模型实验能够沉淀为下一轮研究可复用的基础设施。
论文
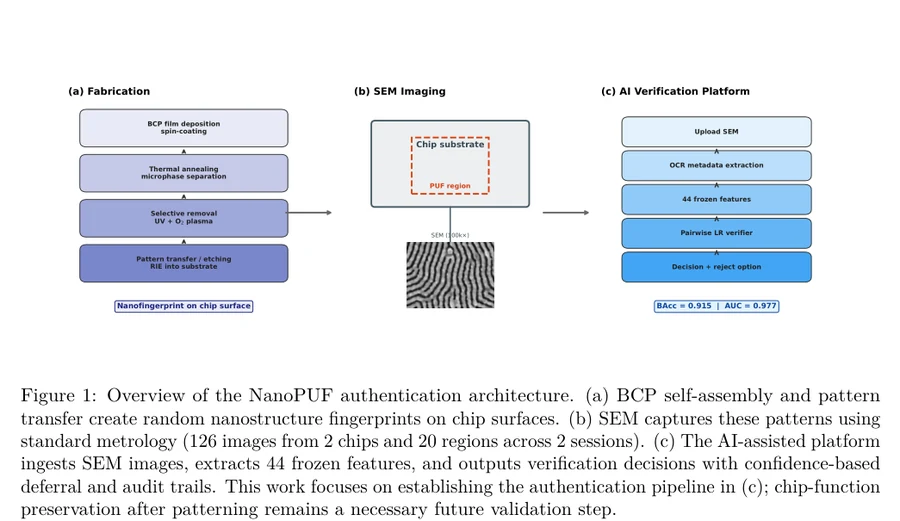
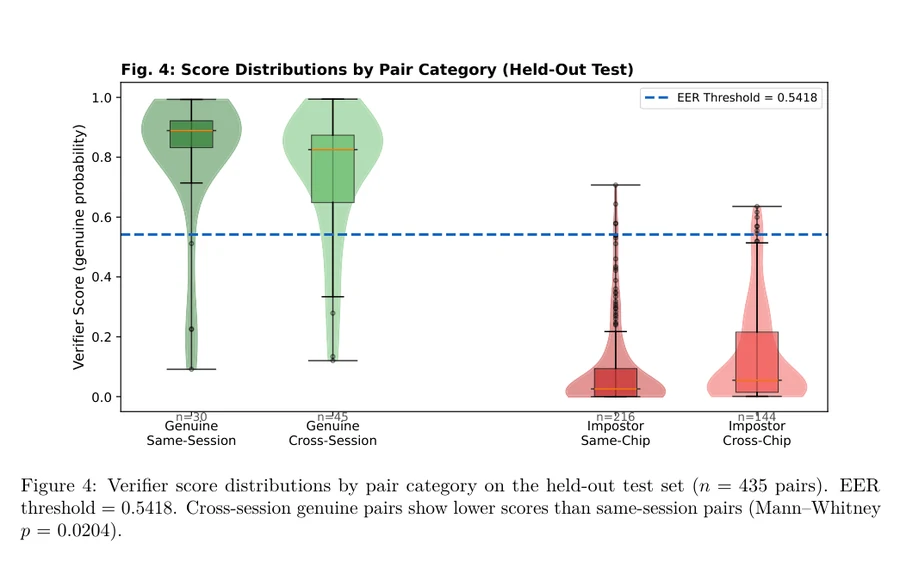
NanoPUF Authentication from Block Copolymer Self-Assembly SEM Images: An AI-Assisted Pilot-Scale Validation and Security Boundary Analysis
以嵌段共聚物自组装 SEM 纳米指纹为物理熵源,构建「图像摄入 → 元数据抽取 → 冻结特征(44 维单图 / 88 维成对)→ 防泄漏成对验证 → 校准与拒绝选项」的完整计算管线;held-out 测试平衡准确率 0.915、AUC 0.977,并显式区分已验证性质与未验证性质(克隆抗性、重放抗性、建模攻击抗性、长期漂移)。
Donor-Acceptor 有机光催化剂性能预测模型研究(Engram-EScAIP)
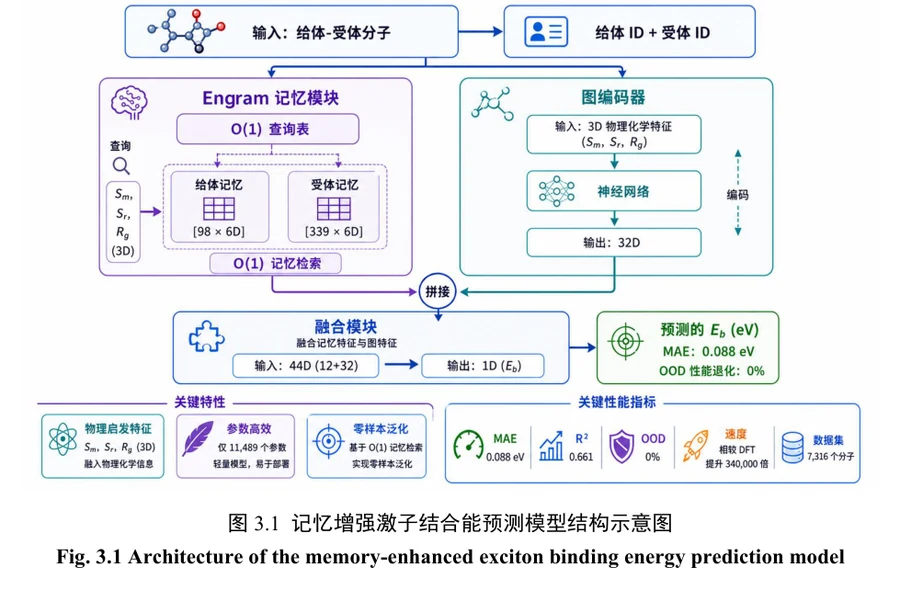
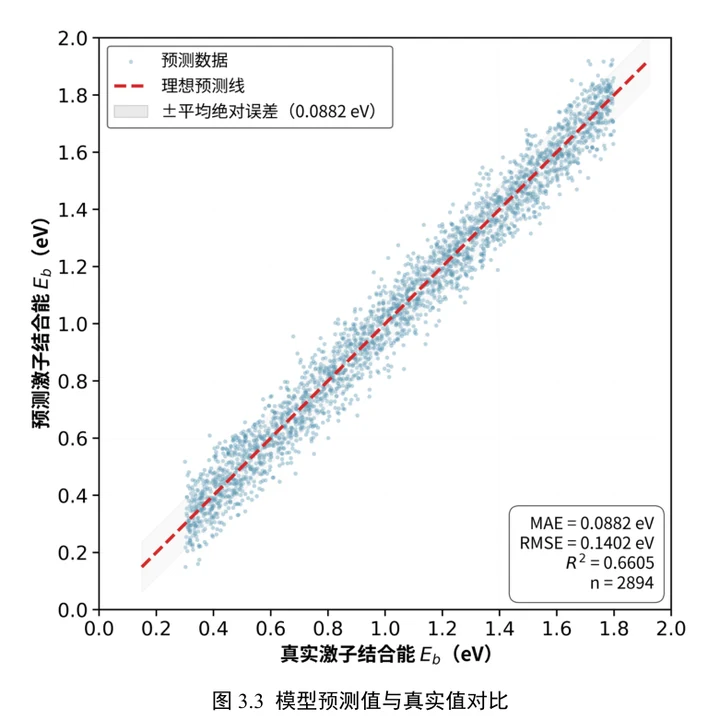
构建 7316 个 D-A 分子组合数据集(93 供体 × 323 受体片段),引入 donor/acceptor 片段记忆机制(Engram-EScAIP),随机测试集 MAE 0.0882 eV;并设计了 ExcitationNexus 原型系统,将分子管理、结构生成、计算任务跟踪、结果解析与模型预测连成闭环工作流。
我如何做研究 · How I Work
先明确科学问题和验证标准,再组织数据与计算;模型只承担适合它的环节;最终把结果沉淀到可追踪、可复用的 workflow 中。
01
问题定义
把研究目标转换成可计算、可验证的问题,明确目标量、科学假设、成本约束和「什么结果才算有意义」。
02
数据与协议
检查数据来源、计算精度、标签生成方式与潜在泄漏;先冻结评估协议,再开始模型比较。
03
计算资产
针对科学问题建立合适的计算层级(PM6 → DFT → TDDFT/Multiwfn),使低成本 proxy 与高精度 reference 有清晰边界。
04
模型与消融
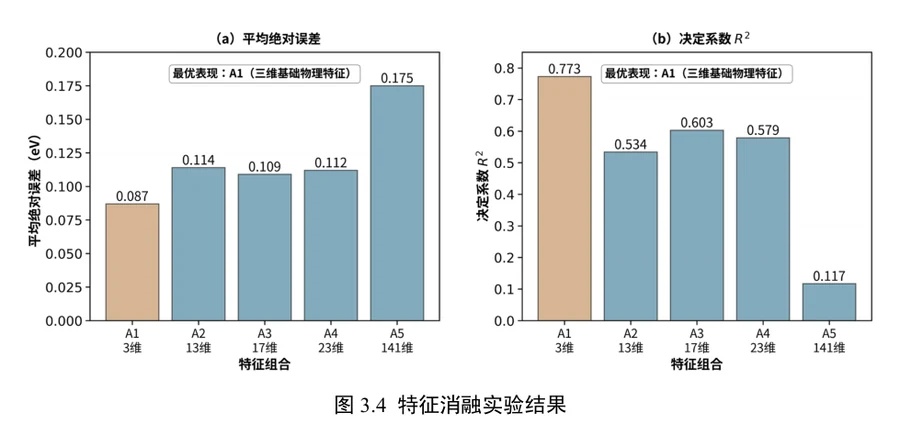
从简单基线开始,逐步加入 3D 表征、片段结构或低成本物理特征;通过消融、负结果和独立测试判断增益是否真实。
05
可靠性检查
关注 OOD、错误分布、阈值、拒绝 / 延迟决策等问题,避免只报告单一平均指标。
06
工作流平台化
将数据、计算任务、特征、模型版本、结果和审计记录放进可追踪系统,减少科研流程对零散脚本和人工记忆的依赖。
07
候选与验证
把模型输出用于排序、初筛或优先级建议,并明确模型只是辅助层,高精度计算和实验仍是最终验证的一部分。
08
复盘与下一轮
记录哪些路线有效、哪些路线失败,以及下一轮最值得补的数据与实验,使一次研究迭代能够累积成长期资产。
科研 Agent / AI 工具的使用原则
AI-assisted, verification-first。
- 把 Agent 用在任务拆解、文献梳理、代码与实验流程组织、结果检查和重复性工作上,而不是把未经验证的生成内容直接当作科学结论。
- 复杂开发任务强调目标驱动、最小化修改、验证检查点和透明处理不确定性;对模型、代码和数据操作保留可审计记录。
- 对长期项目尽量沉淀可复用 Skill / workflow,让下一次研究减少重复搭环境、找文件和恢复上下文的成本。
对研究感兴趣?
AI for Science、分子机器学习、量子化学、科研 Agent——欢迎交流。